Strata serves 125B Qwen3.8-Flash-Next coding model on a single RTX 5090
Open-source engine Strata runs the 125B MoE model Qwen3.8-Flash-Next on a rented 32 GB RTX 5090 using DASLab's 1-bit Coder build (58.4 GB) and a 256K context. One developer gets 144 tokens/s, four get 38 each and eight get 19 each, with total throughput staying flat.
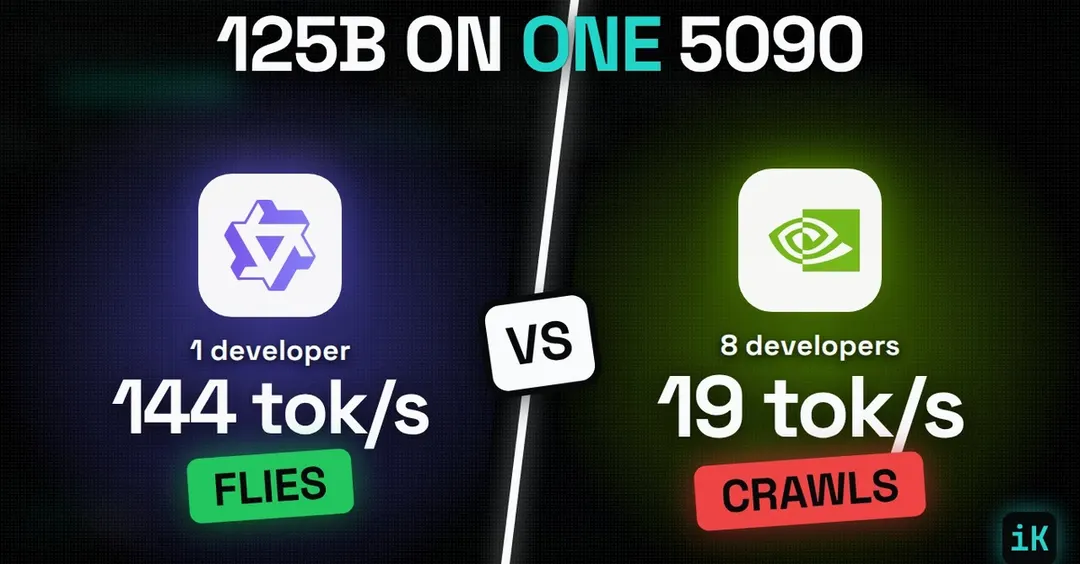
- Single user: 144 tokens/s, first token under 2 seconds
- Four concurrent users: 38 tokens/s each, 125 total
- Eight concurrent users: 19 tokens/s each, 130 total
- SWE-bench Verified quality: 75.6% vs 82.8% for the full model
Read next
AI