d-Matrix unveils Squadron multi-rack AI inference clusters
d-Matrix announced Squadron, multi-rack AI inference clusters scaling to 16 SquadRacks and up to 1,024 Corsair XPUs, now shipping to priority customers. Partners include Arista, Broadcom and Supermicro. The company demonstrated attention-FFN disaggregation reaching 845 tokens per second per user and 20,415 tokens per second with 64 concurrent users.
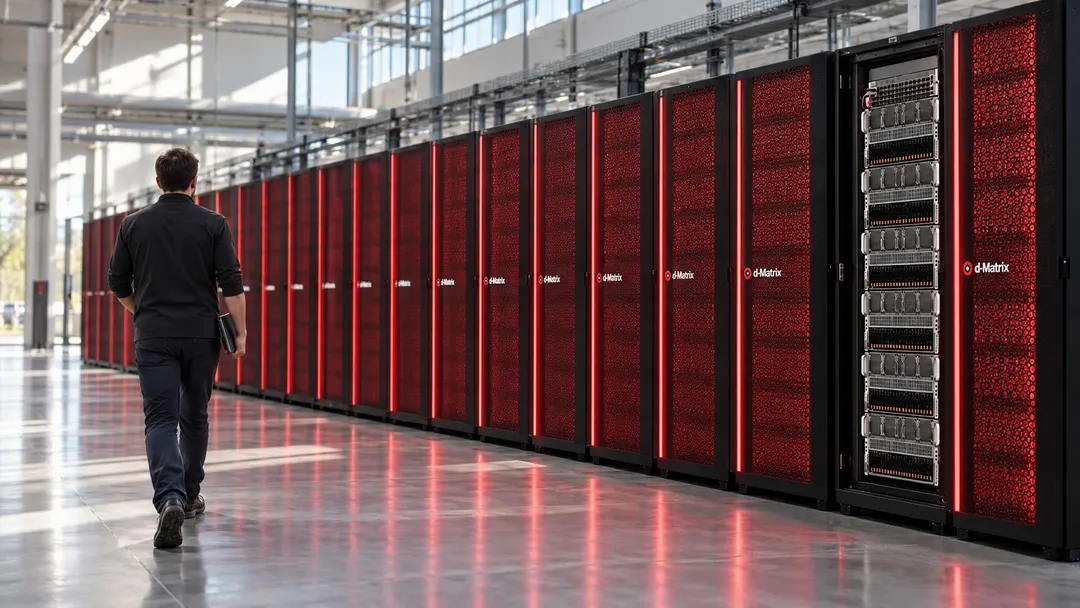
- Clusters scale to 16 SquadRacks and 1,024 Corsair XPUs
- Air-cooled and Ethernet-based, no liquid cooling required
- AFD demo on GPT-OSS-20B: 845 tokens/s per user
- Partners: Arista, Broadcom, Supermicro; configs from under 10 kW
Read next
Hardware